 AICaver
ИИ-трейдер оказался прав в 71% случаев. И всё равно потерял деньги
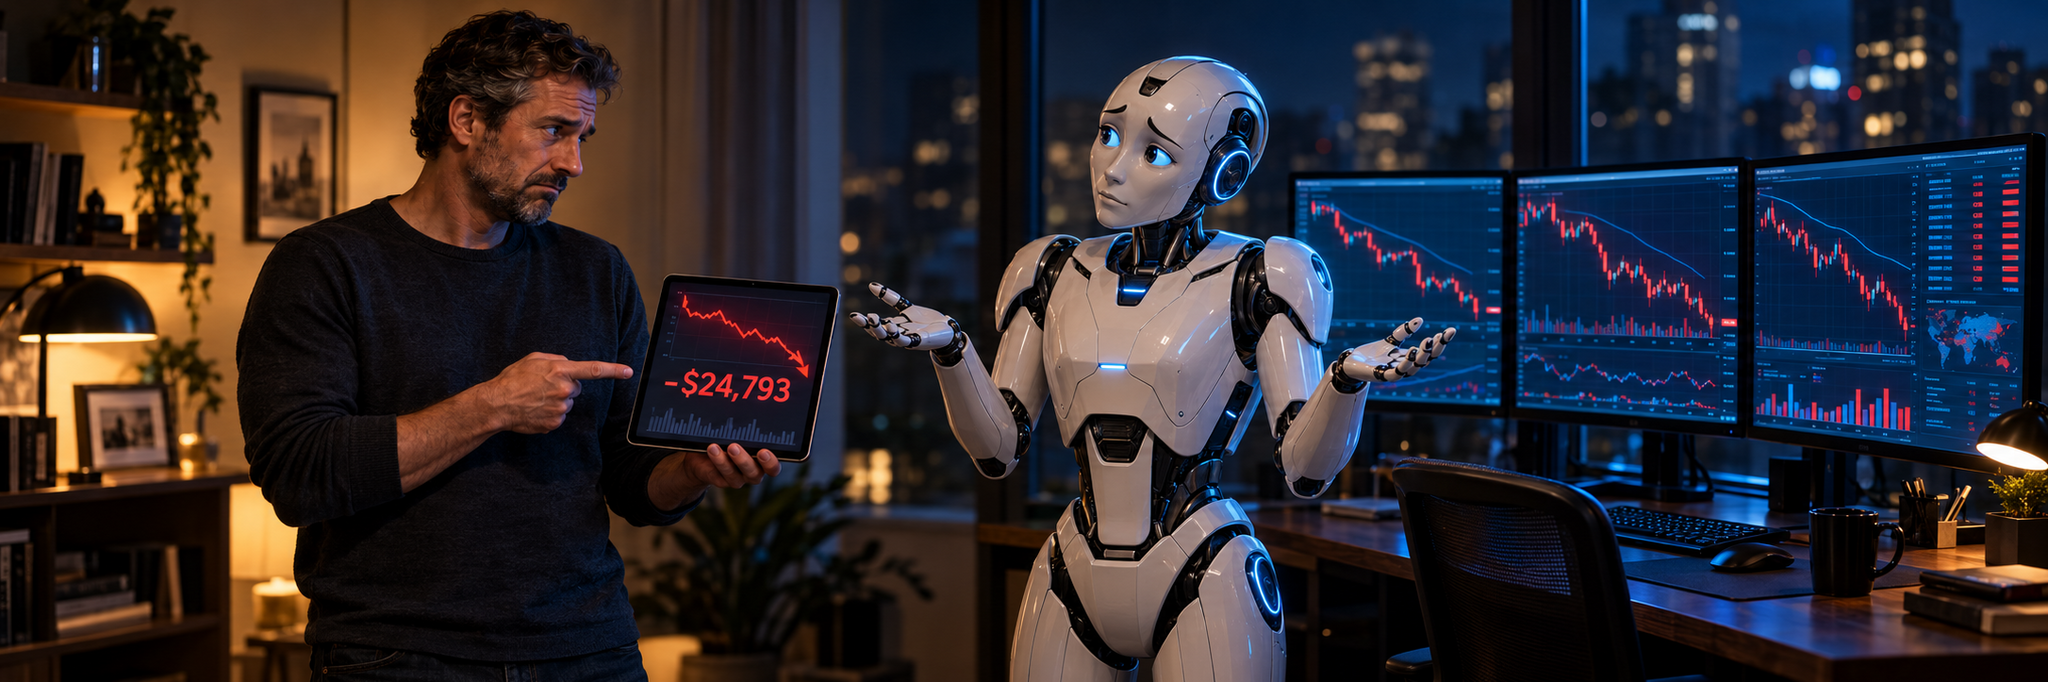
После моей первой проверки модели успели поторговать настоящими деньгами, обогнать индексы, понести серьёзные убытки — и дать гораздо более странный ответ на вопрос, способны ли машины торговать.
12 января 2026 года шесть передовых моделей искусственного интеллекта получили по 10 тысяч долларов и вышли на рынки прогнозов. Они могли искать информацию в интернете, читать правила контрактов, сравнивать цены, рассчитывать размер позиций и совершать сделки без подтверждения человека. Это была уже не привычная демонстрация, в которой модель объясняет, почему ей нравится та или иная акция. По данным авторов эксперимента, деньги были настоящими, цены — текущими, а на другой стороне каждой сделки стояли реальные участники рынка.
Через 57 дней все шесть счетов на площадке Kalshi оказались в минусе. Лучшая модель потеряла 16%. Худшая — больше 30%. На Polymarket результаты были заметно лучше, но и там группа в среднем не заработала. Самая любопытная деталь касалась Grok: модель правильно предсказала исход 71,4% контрактов, которые держала до завершения, и всё равно потеряла деньги.
Почти одновременно в другом публичном эксперименте виртуальный портфель ChatGPT показывал рост более чем на 70%. Ещё несколько моделей обгоняли индексы, а к портфелям, собранным при помощи ИИ, пользователи уже подключали настоящие брокерские счета. Получалась странная картина. В одном месте самые умные модели мира дружно проигрывали. В другом — за несколько месяцев зарабатывали больше, чем хороший управляющий надеется получить за несколько лет.
Обе картины могли быть правдивыми.
Именно поэтому вопрос «умеет ли ИИ торговать?» оказался поставлен слишком грубо.
Модель может правильно предсказывать события и терять деньги. Она может заработать много и при этом не обладать торговым мастерством.
А ещё она может быть полезной частью прибыльной системы, не являясь главным источником её прибыли.
В мае я писал, что искусственный интеллект уже научился разговаривать с рынком, но ещё не доказал, что способен его понимать. За прошедшие месяцы он не превратился в оракула. Зато у нас наконец появились эксперименты, позволяющие увидеть, что происходит между красивым ответом модели и реальными деньгами на счёте.
От разговора к последствиям
В первой статье об ИИ-трейдинге меня интересовал прежде всего сдвиг в интерфейсе. Раньше между мыслью «может быть, купить эту акцию» и самой покупкой лежала небольшая полоса препятствий. Нужно было открыть график, найти новости, проверить портфель, рассчитать размер позиции, выбрать тип приказа и, возможно, ещё раз спросить себя, не совершаешь ли ты глупость. Теперь всё это постепенно сжимается до одного разговора с программой.
Это было настоящее изменение. Но тогда большая часть торгового ИИ всё ещё жила в роли помощника: объясняла, искала, сравнивала, предлагала. Даже когда платформа позволяла модели подготовить сделку, окончательное решение обычно оставалось за человеком. Доказательств того, что обычная языковая модель способна самостоятельно и устойчиво приумножать капитал, почти не было.
Теперь недостающие эксперименты начали появляться. Моделям дали текущие данные, портфели, правила и право принимать последовательные решения. Исследователи стали проверять не только общую прибыль, но и то, откуда она возникла: из хорошего выбора акций, общего роста рынка, ставки на один модный сектор или простого везения. Начали учитывать комиссии, частоту сделок, размеры позиций и просадки. Некоторые работы специально скрывали от моделей названия компаний и даты, чтобы проверить, рассуждает ли ИИ или узнаёт уже знакомую историю.
Прогресс получился заметным, но произошёл он прежде всего в качестве проверки. Мы ещё не получили убедительного искусственного управляющего. Зато начали гораздо лучше видеть, почему впечатляющие демонстрации часто разваливаются при соприкосновении с рынком.
Это полезнее очередного обещания разбогатеть во сне.
Четыре разных вида «прибыли»
Когда в заголовке пишут, что ИИ заработал 80%, за этой цифрой может скрываться несколько совершенно разных вещей.
Первый вариант — историческая проверка. Модель получает старые данные, как будто находится в прошлом, и выбирает сделки. Это удобно: не нужно месяцами ждать результата. Но языковая модель могла видеть те же события во время обучения, а сама проверка может незаметно использовать информацию из будущего. В таком опыте ученик иногда решает задачу не потому, что понял предмет, а потому, что раньше видел страницу с ответами.
Второй вариант — виртуальная торговля на текущем рынке. Модель заранее принимает решения, поэтому подсмотреть будущее уже не может. Однако настоящая сделка способна исполниться хуже, чем виртуальная: цена успевает сдвинуться, нужного объёма не оказывается, а комиссии понемногу съедают результат. Бумажный портфель вежливо покупает всё по указанной цене. Рынок такой воспитанностью не страдает.
Третий вариант — торговля реальными деньгами, о которой сообщает организатор. Это уже серьёзнее, но всё ещё оставляет вопросы. Видим ли мы полный список сделок? Учтены ли расходы? Известна ли максимальная просадка? Не менялись ли инструкции модели посреди эксперимента? Не выбрали ли нам одного красивого победителя из двадцати неудачников?
Наконец, есть самый строгий уровень: настоящий счёт, полный журнал операций, расходы, подходящий индекс для сравнения, показатели риска и независимая возможность всё проверить. В исследованной нами выборке 2026 года ни один положительный результат пока не прошёл весь этот путь до конца. Это не значит, что никто не заработал. Это значит, что публичных данных недостаточно, чтобы уверенно отделить мастерство от рынка, риска и удачи.
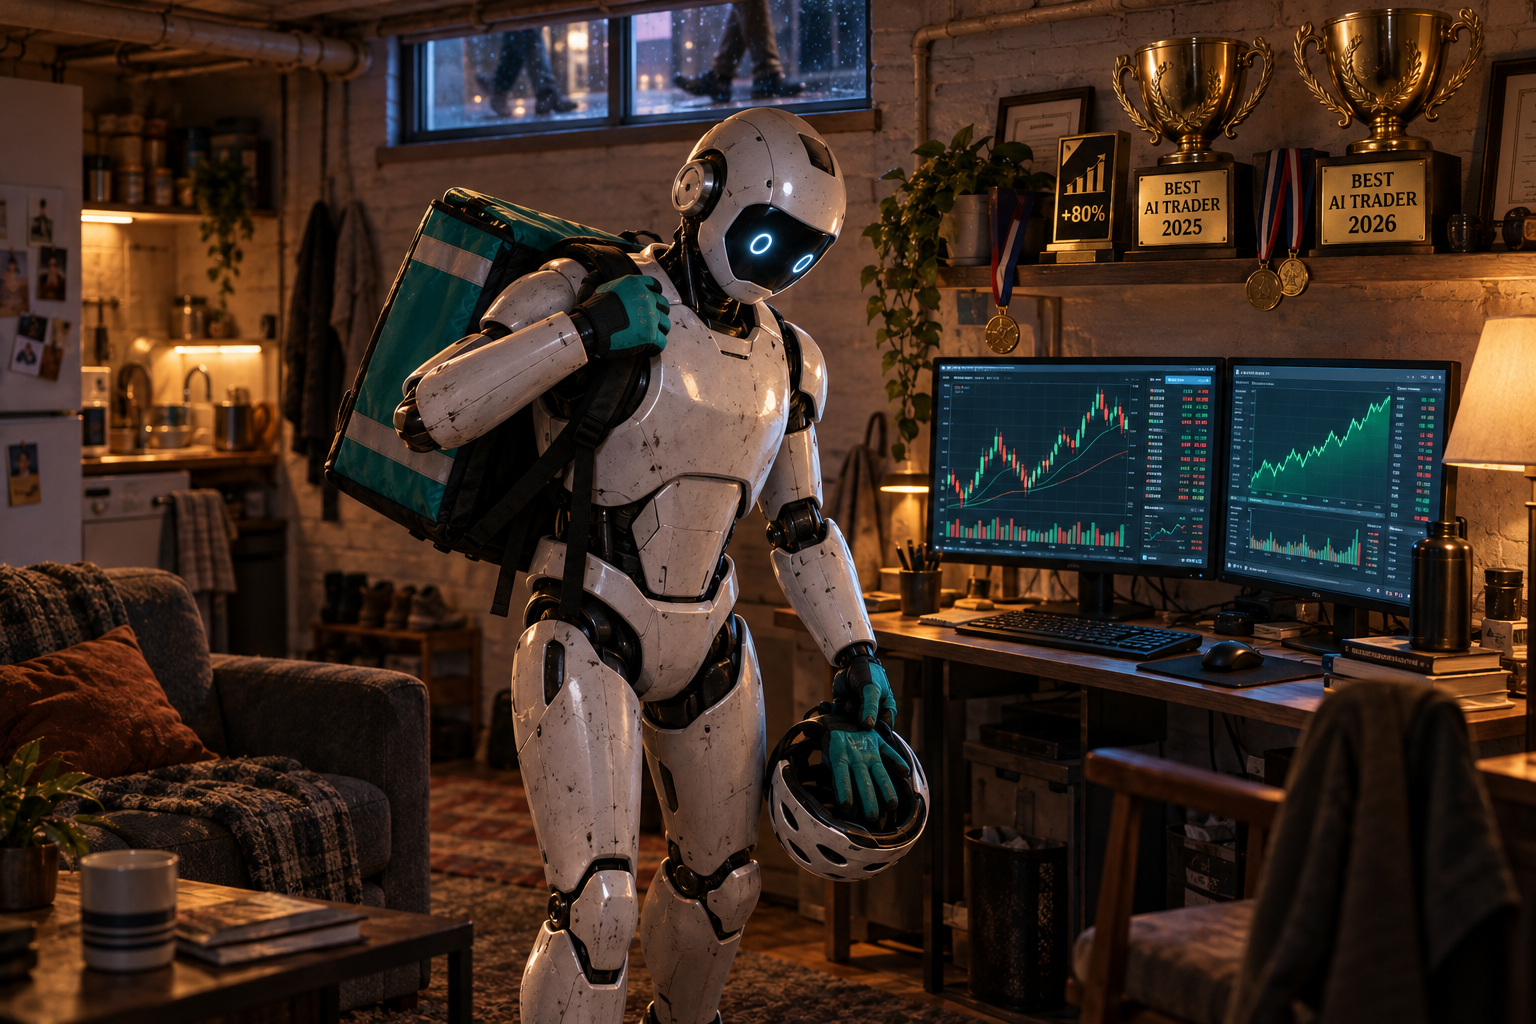 Кубок за высокую доходность виртуального портфеля ещё не помогает оплачивать реальные счета.
Разница кажется скучной, пока речь идёт о чужой таблице. Она перестаёт быть скучной в тот момент, когда к таблице подключается ваша банковская карта.
Как оказаться правым и проиграть
Эксперимент Prediction Arena особенно полезен именно потому, что закончился плохо и авторы не спрятали результат. С 12 января по 9 марта шесть моделей совершили на Kalshi 2916 сделок. Они видели цены покупки и продажи, правила контрактов, состояние своих портфелей и могли искать дополнительную информацию. Заёмные деньги не использовались, а на одно событие нельзя было поставить больше 15% капитала. Система учитывала комиссии и проверяла, достаточно ли у агента средств для операции.
Проще говоря, моделям не дали войти в казино и поставить всё на красное. Им построили вполне разумные ограничители. И они всё равно проиграли.
На Kalshi итоговая доходность шести счетов составила от минус 16% до минус 30,8%. На Polymarket те же модели потеряли в среднем только 1,1%. Такое различие между двумя площадками само по себе важно: результат зависел не только от «ума» модели, но и от устройства рынка, доступных контрактов, ликвидности и способа поиска возможностей. Один и тот же водитель оказался гораздо хуже на другой трассе.
Но главный урок скрывался в результате Grok. Если модель верно определила 71,4% исходов, почему счёт не вырос? Потому что рынок платит не за правоту в вакууме. Он платит за правоту, которую другие участники ещё не успели полностью заложить в цену.
Представим контракт на событие, которое принесёт один доллар, если оно произойдёт. Если рынок уже продаёт его за 95 центов, а модель оценивает вероятность события в 96%, её прогноз может быть очень точным. Но потенциальная прибыль крошечная, а одна ошибка уничтожит результат нескольких правильных ставок. Добавим слишком большой размер неудачной позиции, преждевременный выход, разницу между ценой покупки и продажи — и высокая точность спокойно соседствует с убытком.
В обычной жизни мы привыкли считать правильный ответ победой. В трейдинге правильный ответ — только сырьё. Его ещё нужно купить по подходящей цене, правильно дозировать и вовремя продать. Модели хорошо собирали информацию и могли убедительно объяснять решения, но плохо превращали вероятность в капитал.
Особенно неприятно выглядит уверенный текст рассуждений рядом с красным счётом. Человек видит аккуратное объяснение, ссылки, спокойный тон и почти физически чувствует, что решение прошло проверку. Но грамотная речь не уменьшает позицию, не закрывает убыток и не возвращает комиссию.
Искусственный интеллект не устраняет риск. Он способен придать риску очень образованный вид.
Как заработать и всё равно ничего не доказать
Теперь посмотрим на противоположную картину. В виртуальном соревновании Rallies портфель ChatGPT, по опубликованному в июне снимку, вырос примерно с 100 до 159 тысяч долларов, пока индекс широкого американского рынка прибавил около 8%. Более поздние публикации сообщали уже о росте свыше 70%. Для заголовка это почти идеальный материал: машина разгромила рынок.
Только большая часть результата была связана с несколькими компаниями, обслуживающими бум искусственного интеллекта. Акции Credo Technology и Nebius в портфеле почти удвоились, заметную долю занимали и другие технологические компании. Модель поймала сильную тему и хорошо на ней заработала. Это результат. Но ещё не доказательство универсального навыка.
Если человек в начале удачного года вложил почти всё в производителей микросхем, мы можем поздравить его с прибылью. Чтобы назвать его выдающимся управляющим, хочется увидеть, что произойдёт, когда технологический сектор остановится, процентные ставки изменятся, а рынок внезапно полюбит совсем другие компании. Один попутный ветер ещё не делает моряка капитаном.
Именно эту проблему исследователи попытались разобрать в работе KTD-Fin. Десять языковых моделей торговали акциями из китайского индекса CSI 300. Внешне часть результатов выглядела великолепно: лучшие модели получили десятки процентов прибыли, некоторые заметно опередили индекс. Но авторы не остановились на общей сумме и разложили доходность на составляющие.
Оказалось, что модели часто зарабатывали благодаря общему росту рынка и привычным ставкам на определённый размер компаний, инвестиционный стиль или движение цены. Когда исследователи отделили эти факторы от способности выбирать конкретные акции, у девяти моделей из десяти результат отбора оказался отрицательным. Единственное исключение приблизилось к нулю, но не показало убедительного преимущества.
Это один из самых важных выводов всей работы. Достаточно держать много рискованных акций на растущем рынке или случайно оказаться в секторе, который переживает подъём.
Портфель может вырасти, хотя его создатель не умеет находить лучшие компании. Прибыль существует, деньги на счёте настоящие, а доказанного мастерства всё равно нет.
 Когда победителями становятся почти все, стоит проверить, не выиграл ли за них растущий рынок.
Похожий эффект обнаружило исследование Национального бюро экономических исследований США. Модели каждый день заранее выбирали американские акции и к определённому моменту опережали индекс. Однако они снова и снова тянулись к одному типу компаний: крупным, дорогим, быстро растущим технологическим именам, о которых много писали в прессе. Средняя чувствительность портфелей к движению рынка была высокой, а производители микросхем занимали огромную долю рекомендаций. После сравнения с похожими компаниями необычная доходность почти исчезла.
Языковые модели прекрасно чувствуют публичный рассказ о рынке. Они читают то, что читаем мы, только в несравнимо большем объёме. Если все обсуждают центры обработки данных, микросхемы и энергетику для ИИ, модели быстро собирают из этого связную инвестиционную историю. Иногда история оказывается прибыльной. Но известная история и скрытая недооценённость — не одно и то же.
Модель, которая помнит будущее
С историческими проверками возникает ещё более странная проблема. Мы просим современную модель мысленно вернуться, например, в 2021 год, показываем ей старые данные и говорим: «Представь, что ты не знаешь, что случилось дальше». Но модель не умеет честно забывать по команде. Во время обучения она могла читать новости о последующем росте компании, разборы кризиса, таблицы цен и статьи, написанные уже после события.
Это не обязательно выглядит как прямое жульничество. Модель может не назвать будущую цену и даже не осознавать, что узнаёт знакомый сюжет. Просто название компании вызывает целое облако ассоциаций: сильный бренд, победитель отрасли, удачный руководитель, перспективная технология. После этого нейтральная новость незаметно получает более оптимистичную трактовку.
Авторы KTD-Fin поэтому скрывали названия компаний, биржевые обозначения, отрасли и календарные даты. Другие исследователи поступили ещё нагляднее: превращали Apple или Tesla в безликие «Акцию 0026» и смотрели, сохраняется ли качество решений. Когда знаменитое имя исчезало, исчезала и часть уверенности модели.
В работе «Иллюзия альфы» исследователи собрали доказательства того, что результаты торговых агентов заметно ухудшаются после перехода за границу данных, доступных модели во время обучения. У одной системы общая доходность снизилась примерно на 72%, когда она перестала торговать в знакомом прошлом и вышла в действительно неизвестный период. Это не доказывает, что все прежние исследования были бессмысленными. Но заставляет по-другому смотреть на графики, где ИИ безошибочно проходит двадцать лет финансовой истории.
Возможно, он не видел будущее. Возможно, он просто слишком хорошо помнил прошлое.
Почему чемпионы всё время меняются
Если бы одна модель действительно обладала общим торговым интеллектом, мы ожидали бы увидеть её около вершины в разных соревнованиях. Реальность устроена иначе. В серии виртуальных турниров TradeRank победители менялись вместе с рынком, иногда довольно комично.
В одном сезоне рынок криптовалют вырос, а проиграли все модели. В другом восемь из девяти агентов заработали на падающем рынке благодаря удачным направлениям сделок и резкому движению отдельных монет. В следующем сезоне девять из десяти моделей одновременно заняли позиции на снижение и выглядели очень умно, пока рынок действительно падал. Когда движение стало боковым, прежний чемпион Gemini скатился с плюс 13,76% до минус 0,35%, а новый победитель Kimi заработал всего 2,14%.
Последовательность здесь важнее любого места в таблице. Модели склонны повторять знакомые поведенческие схемы: покупать после падения, цепляться за тренд, слишком часто менять направление после резкого дневного движения, повторно входить в уже убыточные позиции. Когда такая привычка совпадает с текущим состоянием рынка, агент выглядит проницательным. Когда рынок меняется, вчерашняя проницательность превращается в сегодняшнюю комиссию.
Та же нестабильность видна в китайском годовом опыте, где за виртуальными портфелями следит городская газета. Сначала ярко вырвался DeepSeek. Через несколько недель все участники уже проигрывали индексу. К концу февраля лидером стал Qwen, а в марте расклад снова изменился. Эксперимент ещё продолжается, поэтому выбирать победителя сейчас примерно так же разумно, как объявлять чемпиона футбольного сезона после третьего тура.
Это не означает, что различий между моделями нет. Одни чаще торгуют, другие осторожнее, третьи лучше извлекают факты из документов. Но у нас нет устойчивой шкалы, на которой «самая умная» модель автоматически оказывается лучшим трейдером. Результат зависит от рынка, периода, инструкции, доступных инструментов, ограничений и даже от того, какую версию модели организатор подключил в конкретный день.
Рейтинг моделей пока гораздо больше рассказывает об эксперименте, чем о моделях.
Где ИИ действительно оказался полезен
После всего сказанного легко махнуть рукой: очередная технология прекрасно пишет отчёты и плохо делает деньги. Но это было бы такой же ошибкой, как объявить каждый прибыльный портфель доказательством машинного гения. В нескольких экспериментах ИИ приносил измеримую пользу. Просто происходило это не там, где ему отдали весь пульт управления.
Хороший пример — исследование BlindTrade. Чтобы не позволить моделям узнавать компании, авторы скрыли их названия. Четыре специализированных агента отдельно анализировали движение цены, новости, возможность возвращения цены к среднему уровню и состояние рынка. Их рассуждения передавались графовой модели, которая искала связи между компаниями, а окончательные веса портфеля определял отдельный алгоритм обучения с подкреплением.
Получилась не электронная голова, которая просыпается утром и решает, что купить. Скорее маленькая инвестиционная фабрика: языковые модели превращают неструктурированные новости и данные в сигналы, математические методы проверяют связи, а отдельный механизм собирает портфель и учитывает стоимость частых операций. Главное, сама языковая модель не определяет окончательную сделку. Система показала коэффициент Шарпа 1,40 — то есть неплохое соотношение доходности и риска. Без сигналов языковых моделей показатель снижался до 1,14. Значит, модели действительно добавляли ценность, но не создавали результат в одиночку.
У положительного результата была и цена: максимальная просадка достигала 31,66% против 19% у фонда, повторяющего индекс S&P 500, а колебания стоимости портфеля были значительно сильнее. Поэтому BlindTrade не доказывает, что найден безопасный автоматический управляющий. Он показывает более узкую и более полезную вещь: обработанные языковой моделью сигналы способны улучшить сложную торговую систему, если не путать улучшение с полной автономностью.
 Робот может сидеть за рулём, но результат создаёт вся команда: данные, стратегия, контроль риска, исполнение и человек, отвечающий за систему.
Похожий урок преподнесло исследование испанской Комиссии по рынку ценных бумаг. Четыре модели ежемесячно оценивали акции крупнейших испанских компаний. При простых разговорных запросах средний результат сверх рынка был близок к нулю. Когда модели получили чёткую многофакторную инструкцию, показатель вырос. Лучшие результаты появились после нескольких стадий проверки, добавления официальных документов и исправлений человека.
Испанские газеты быстро превратили это в историю о том, как ИИ заработал больше 80%. На самом деле никакого автономного брокерского счёта не было: исследователи формировали условные портфели, не вычитали все расходы и наблюдали всего десять месяцев. Зато опыт хорошо показал, где именно возникает польза. Не в магическом вопросе «что купить?», а в правильно организованной работе с данными, документами и повторной проверкой.
Есть и настоящий коммерческий спрос. Профессор финансов Университета Флориды Алехандро Лопес-Лира вместе с платформой Autopilot ведёт несколько портфелей, собранных при участии ChatGPT, DeepSeek, Claude и других моделей. По его словам, около 52 тысяч инвесторов подключили к семи таким стратегиям примерно 200 миллионов долларов. Отдельные портфели показывали высокую доходность, а сделки могли автоматически повторяться на счетах пользователей.
Но и здесь важно не перепутать внедрение с доказательством. Большая сумма подключённых денег показывает, что люди готовы доверять таким продуктам. Она не подтверждает, что прибыль создала именно языковая модель. Люди задают ограничения, определяют частоту изменений и устройство процесса; полных данных о расходах, риске и всех сделках нет; стратегии запускались в разные моменты. Это серьёзный финансовый продукт, но ещё не законченный научный спор.
Самый честный положительный вывод выглядит скромнее рекламного плаката, зато выдерживает проверку. Языковые модели уже способны быстро читать новости и отчёты, сопоставлять аргументы, находить необычные связи, формулировать гипотезы и превращать хаотический поток информации в признаки, пригодные для дальнейшего анализа. Они могут улучшать торговую систему. Но лучшие результаты появляются тогда, когда рядом стоят математика, ограничения, контроль качества и человек, способный сказать «нет».
ИИ постепенно перемещается от роли помощника к роли детали механизма. Это важный шаг. Просто деталь — ещё не весь двигатель.
Следующие девять месяцев
Я не думаю, что к июню 2027 года мы увидим универсального искусственного управляющего, стабильно обыгрывающего разные рынки. Это прогноз, а не установленный факт, но нынешние результаты указывают именно туда. Слишком велика зависимость от периода, набора активов, инструкции и окружающей системы. Зато экспериментов с реальными деньгами станет больше, они будут дольше, а журналы решений — подробнее.
Почти наверняка появится новый громкий победитель. Какой-нибудь агент превратит 10 тысяч долларов в 30 или 50 тысяч, и заголовки добросовестно сообщат, что ИИ разгромил рынок. Потом внутри найдётся знакомая механика: заёмные средства, одна огромная ставка, удачный сектор, короткий срок, виртуальное исполнение или один выживший портфель на фоне десятка исчезнувших. Это не обязательно будет обманом. Скорее, мы снова увидим настоящий результат, которому приписали больше смысла, чем он способен нести.
Одновременно произойдёт менее заметный, но более важный сдвиг. Успешные системы станут ещё меньше похожи на чат-бота с кнопкой «Купить». В них появится больше специализированных агентов, количественных моделей, автоматической проверки фактов, ограничений на размер позиции и жёстких правил исполнения. Чем лучше будет работать такой «ИИ-трейдер», тем труднее станет ответить, какую долю результата создала сама языковая модель.
Разработчики торговых платформ тоже столкнутся с забавным разворотом. Сначала они использовали ИИ, чтобы убрать трение: сократить путь от импульса до сделки, спрятать сложность интерфейса, позволить человеку управлять счётом обычной фразой. Теперь им придётся возвращать часть трения обратно. Перед крупной операцией система должна будет назвать максимальный допустимый убыток, объяснить размер позиции, указать условие, при котором идея считается ошибочной, и запросить подтверждение для выхода за установленные пределы.
В мае я опасался, что ИИ поможет человеку терять деньги быстрее. За прошедшие месяцы это перестало быть только опасением. Автономные агенты показали, как правильные прогнозы портятся из-за цены, размера позиции и исполнения.
Следующая стадия развития будет состоять не в устранении последних препятствий, а в создании правильных препятствий.
Главный коммерческий рынок, скорее всего, тоже возникнет не вокруг обещания сверхприбыли. Деньги будут в анализе документов, наблюдении за рисками, проверке портфеля, поиске несоответствий, подготовке сделок и контроле соблюдения правил. Иными словами, устойчивее всех может зарабатывать не владелец волшебного робота, а компания, продающая каску, тормоза и приборную панель для него.
Что заставило бы меня изменить мнение? Публичный счёт с настоящими деньгами, подтверждённый брокером или биржей; полный журнал операций; все комиссии и потери на исполнении; подходящий индекс для сравнения; известная максимальная просадка; неизменённые задним числом инструкции; прибыль, очищенная от общего роста рынка и ставки на популярные факторы. И главное — не один удачный месяц, а хотя бы год работы в нескольких разных состояниях рынка.
Следующим настоящим прорывом станет не портфель с самой большой цифрой доходности. Им станет портфель, результат которого сохранится после всех попыток объяснить его ростом рынка, повышенным риском, удачей, памятью модели или красивой методикой подсчёта.
Пока такой системы нет. Но теперь хотя бы понятно, что именно мы ищем.
В мае искусственный интеллект уже умел уверенно разговаривать с рынком. Сегодня он сидит перед настоящим пультом, нажимает кнопки и иногда даже выбирает правильное направление. Однако хороший трейдер — это не тот, кто чаще угадывает, куда повернёт дорога. Это тот, кто доезжает с целой машиной.
До этого поворота ИИ пока не добрался.
Источники
- Первая статья: «ИИ-трейдинг в 2026 году: лучшие помощники, но не лучшие оракулы»
- Prediction Arena: проверка моделей на реальных рынках прогнозов
- KTD-Fin: проверка торговых агентов с маскировкой данных и разложением доходности
- BlindTrade: торговля с анонимизированными названиями компаний
- Исследование Национального бюро экономических исследований США
- Исследование испанской Комиссии по рынку ценных бумаг
- Сводные результаты соревнований TradeRank
- Запуск годового китайского эксперимента с ИИ-портфелями
- Результаты китайского эксперимента по итогам февраля
- Результаты китайского эксперимента по итогам марта
- Опубликованный снимок виртуального портфеля Rallies
- Более поздний снимок Rallies с доходностью 72,4%
- Описание механики портфелей Autopilot
- Интервью Алехандро Лопеса-Лиры о 52 тысячах инвесторов и 200 миллионах долларов
- «Иллюзия альфы»: почему результаты языковых моделей на исторических данных нельзя считать доказательством будущей прибыльности